PG关注到,研华8月31日发布AI推理平台指南,介绍训练后模型进入持续运行环境的需求,并说明WEDA在分布式部署中的角色。资料明确推理应用与运行环境保留在客户容器内,本文围绕这项边界讨论平台整合。
模型文件、推理运行环境和设备管理承担不同工作。一个平台能够分发文件,并不必然负责执行全部模型;理解这种分工,有助于团队判断需要准备哪些软件,以及出现问题时应核查哪一层。
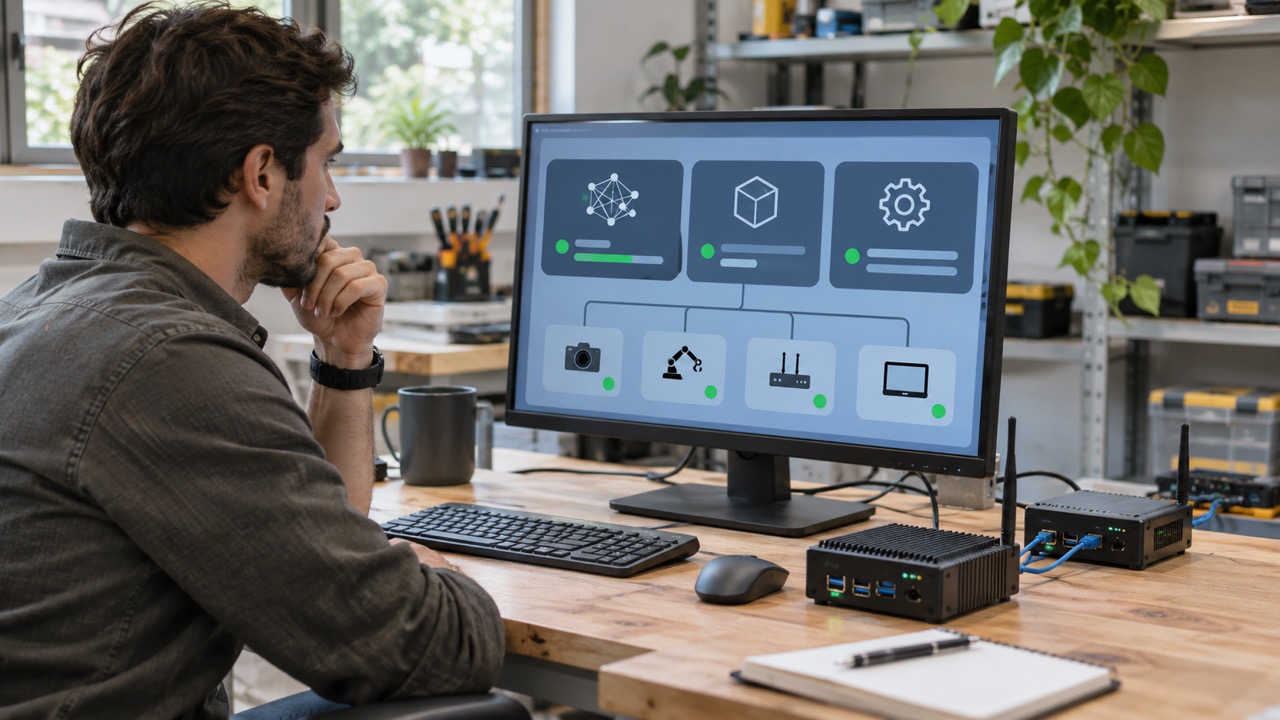
模型能运行,需要一整套适配条件
官网说明WEDA Core负责集中协调,WEDA Node在边缘设备管理工作负载;客户可保留自己的容器化推理方案,并利用平台管理批准模型文件的登记、版本与部署。具体支持范围需要按实际设备和软件核对。
独立观察认为,模型文件与目标设备之间还隔着运行环境。支持的运算、数据格式和驱动版本若不匹配,就可能影响执行;因此部署资料不应只写文件已经发送,还应注明它对应哪套应用配置。
输入与输出也需要清楚契约。模型需要怎样的尺寸、格式与预处理,返回什么类别或分数,应由应用团队说明。否则,平台可能正确交付文件,而业务仍无法正确使用结果。
发布过程应区分送达与生效
文件上传、设备下载和应用实际采用新版本,是不同阶段。维护界面若将它们统一显示为部署完成,就可能让管理员误判,尤其是在设备暂时离线或应用尚未重新加载时。
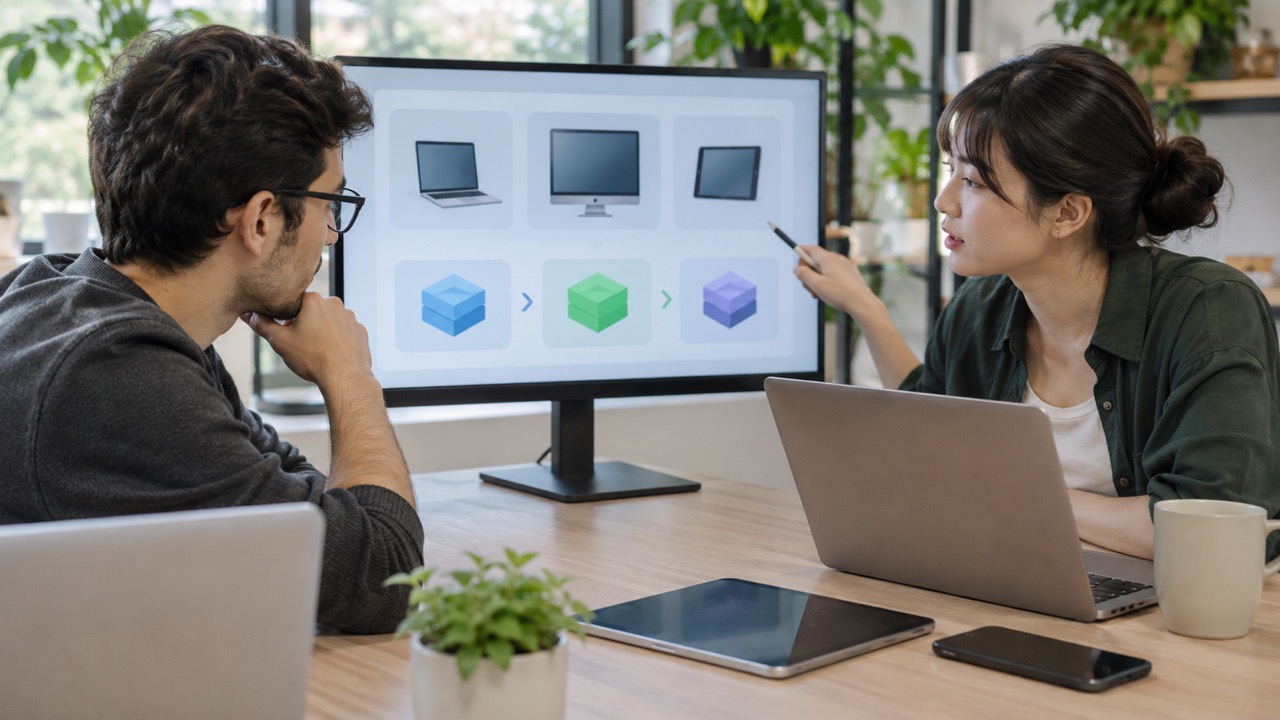
从独立工程分析看,版本状态应能关联到设备与应用。哪台节点已经运行新版本、哪台仍在等待,以及哪些发生异常,需要有可核查记录,才能解释同一时间不同地点输出为何不一致。
回退也不只是重新发送旧文件。配置、输入处理与下游解释是否仍兼容,应一同检查。若模型版本影响输出含义,应用和业务层也需要知道变化,不能把恢复责任全部交给编排工具。
性能验证要覆盖实际请求流程
推理时间只是完整任务的一段。数据进入、预处理、排队与结果发送都可能产生等待,评估应说明测量从哪里开始、到哪里结束,避免用单一步骤代替使用者感受到的响应。
并行任务也需要实际观察。多个输入或服务共同使用资源时,单独模型测试未必能说明持续表现;记录输入组合和版本,有助于让结论对应明确条件,而不是泛称平台高性能。
异常排查需要跨层证据。设备健康、容器状态和应用结果各自提供不同信息,若能使用共同时间与标识,团队就更容易确定问题发生在哪一步,减少反复转交。
原文中的通用计算占比和行业效果描述没有附统一验证条件,本文不沿用为确定数值。公开指南能够解释平台角色,实际成效仍应由任务、配置和运行记录说明。
交付文件也应列明各方负责范围:平台维护、推理环境与应用逻辑分别由谁处理,变更后怎样核查。这样的责任关系有助于把开发成果转为可持续运行的服务。
上线检查还应覆盖外部连接与后续接收。模型输出正常,并不代表结果已经到达业务系统;保留发送与确认状态,有助于区分推理成功和完整服务成功,也能为异常复查提供更清楚的时间线。
在PG看来,推理平台的价值需要通过明确分工体现。保留客户运行环境的边界,建立文件送达、版本生效与任务验证的记录,才能准确评价WEDA等编排能力在完整应用中的作用。